「同じ AI モデルを使っているのに、ツールによって出来も料金もまるで違う」という経験は、コーディングエージェントを触った人なら一度はあるはずです。
その差を生んでいるのが、モデルの外側にあるハーネス(harness)と呼ばれる部分。
モデルの単価ばかり見ていると、この部分のコストは見えません。
何がその差を生んでいるのかは、公開されている評価と Anthropic の設計指針を並べると輪郭が見えてきます。
ハーネスとは「モデルを仕事に就かせる周辺一式」
ハーネスは、もともと馬具(引き具)を指す言葉です。
AI の文脈では、LLM を実際の作業に接続するための周辺コード一式を指してこう呼びます。
具体的には、システムプロンプトの組み立て、ツール(ファイル操作・シェル・検索など)の定義と実行、会話履歴やコンテキストの管理、ループの制御(いつ止めるか・何回まで試すか)、といった部分ですね。
Anthropic の「Building effective agents」では、こうした部品を持つ LLM を拡張された LLM(augmented LLM)と呼び、検索・ツール・メモリを足したものをエージェントの基本ブロックとして説明しています。
同じ文書は、エージェントとは LLM が自分の処理とツール使用を動的に決めるシステムであり、あらかじめ決めたコードの経路で動くワークフローとは区別する、と定義しているのです。
つまりハーネスは、モデルに「何を見せ、何を使わせ、いつまで続けさせるか」を決めている側。
モデルが同じでも、ここが違えば別のエージェントになります。
同じモデルで 17 倍のコスト差が出た評価
この「ハーネスの差」を数字で見せた公開評価が出ました。
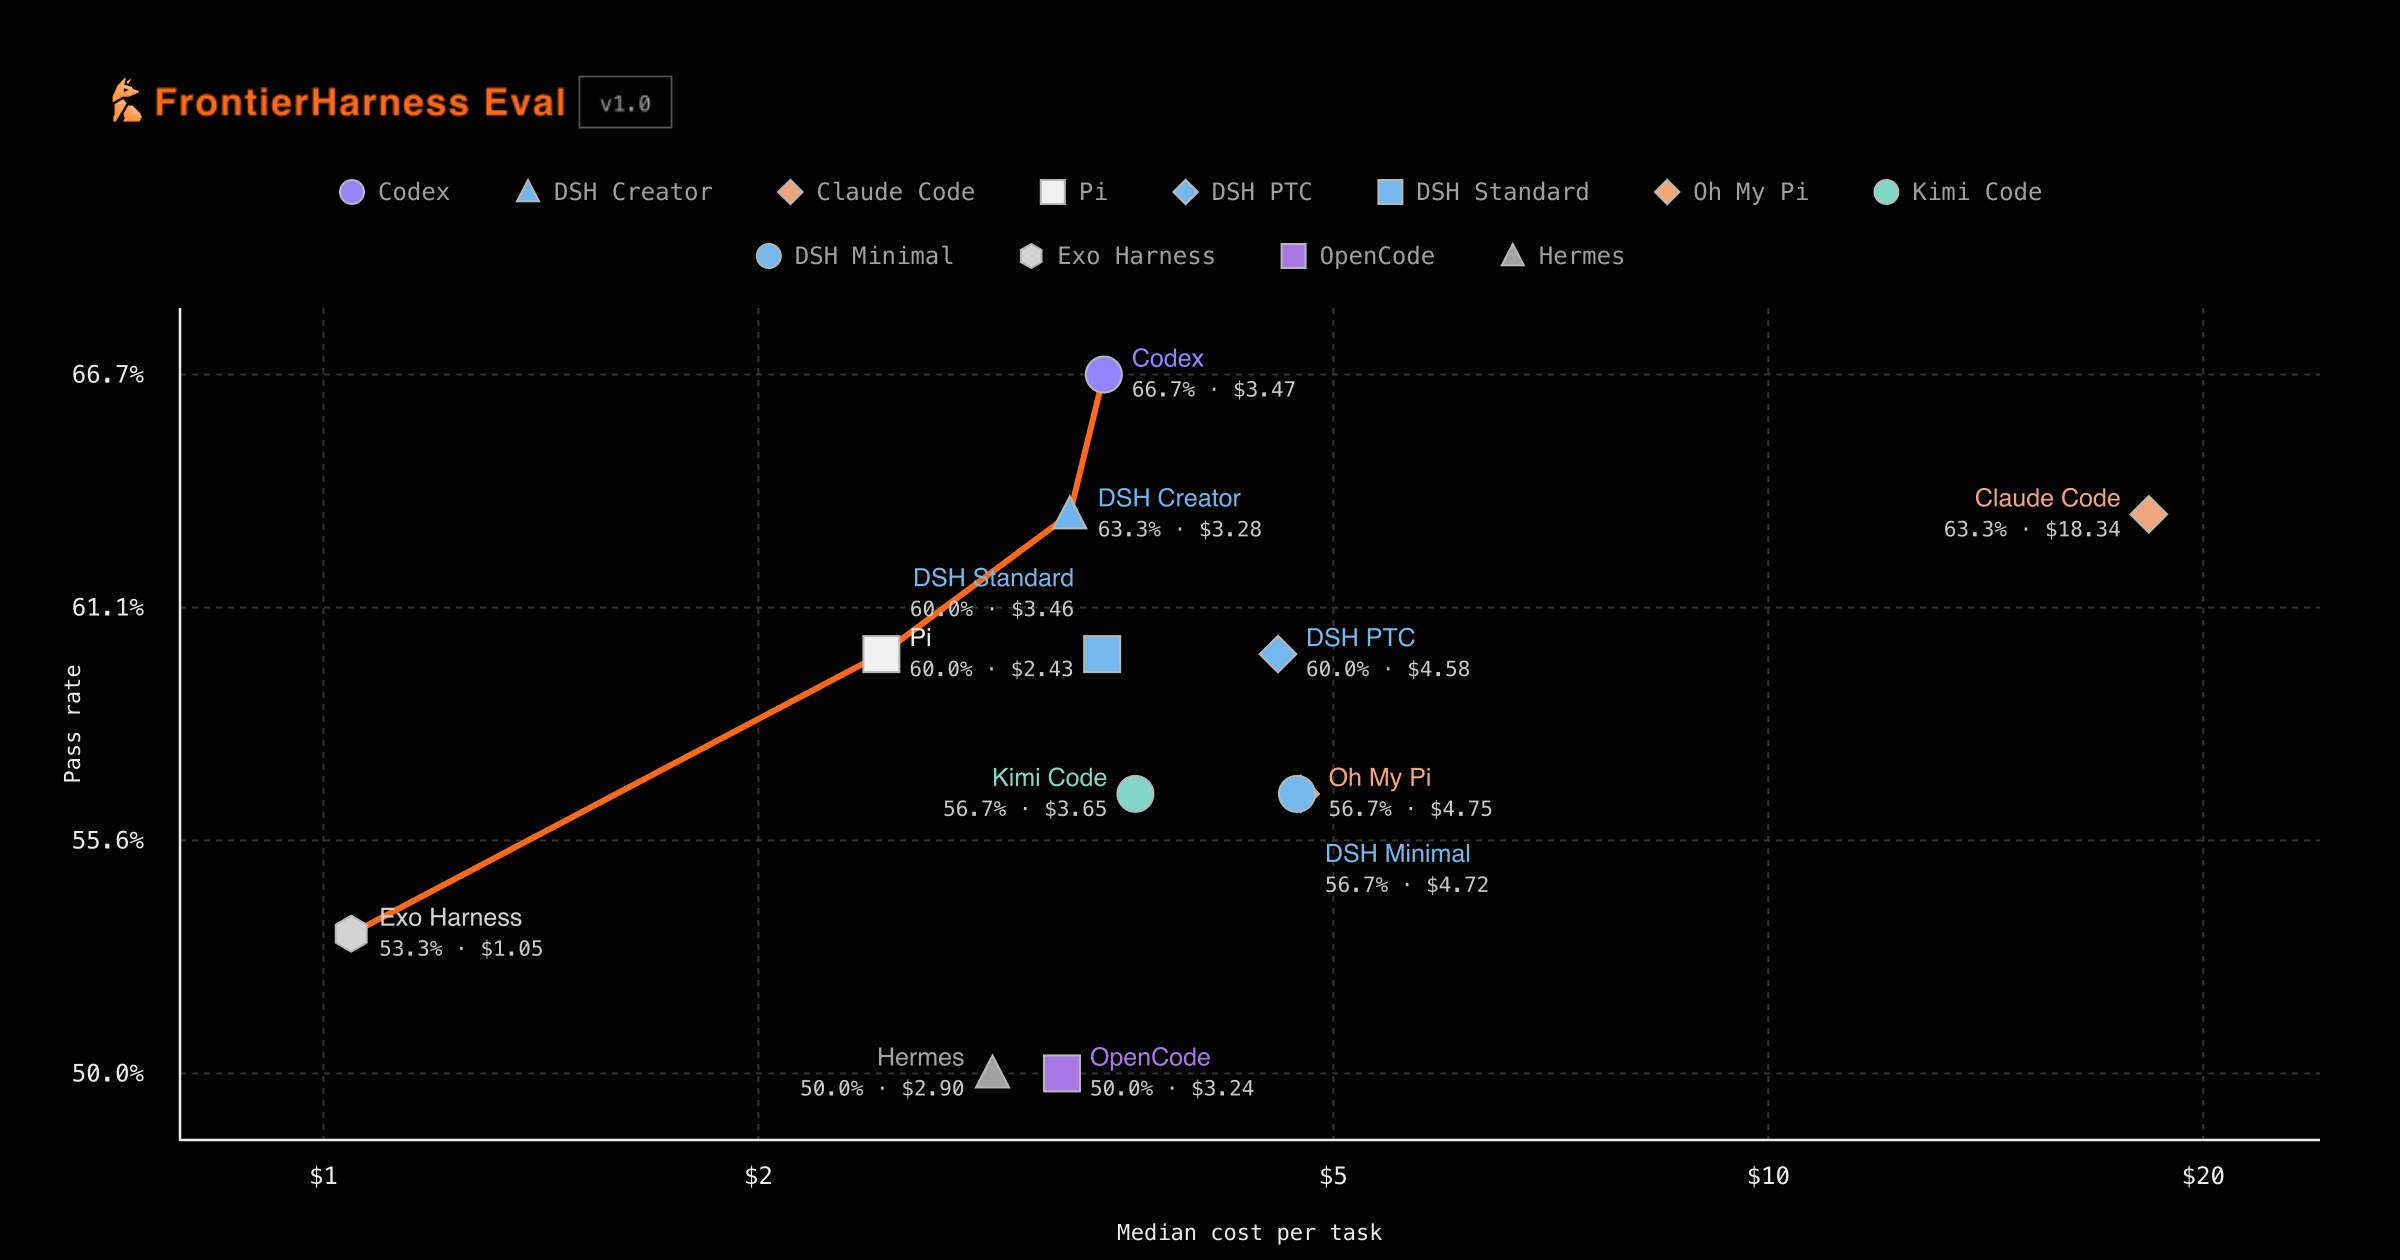
FrontierHarness Eval という評価で、モデルを Kimi K3 に固定し、9 種類のハーネスに同じソフトウェア開発タスクを解かせて 360 回試行したものです。
各実行は同じ vCPU・メモリ・ディスク内容・メモリ状態から復元して始めており、キャッシュが温まっている有利さも揃えてあります。
結果は、1 タスクあたりのコストが最安 1.05 ドルから最高 18.34 ドルまで、およそ 17 倍の開きでした。
一方で合格率は 50.0% から 66.7% の範囲に収まり、いちばん通ったのは Codex(66.7%・1 タスク 3.47 ドル)、いちばん速かったのは中央値 5 分 41 秒のハーネスとなっています。
評価ページ自身がまとめているとおり、品質とコストは乖離するし、キャッシュのヒット率が高ければ安くなるという単純な関係でもありません。
安い・速い・通るがそれぞれ別のハーネスに分かれていたのが、この評価のいちばんの示唆でしょう。
なお、ハーネスごとの設定が結果を大きく左右する性質の評価なので、数字は「差が出る」ことの証拠として読み、自分のタスクでの再測定が前提です。
なぜハーネスでコストが変わるのか
差が生まれる場所は、大きく 3 つに整理できます。
1 つ目はコンテキストに何を詰めるかです。
ファイル全体を毎回読ませるのか、必要な部分だけ切り出すのか、過去の会話をどこまで残すのか。
入力トークンはそのまま料金なので、詰め込み方が雑なハーネスは、同じ答えにたどり着くまでに何倍も払うことになります。
2 つ目はループの回し方で、失敗したときに何回まで自動で試し直すか、途中で「もう十分」と判断できるか、が効いてくるところ。
考えて、動いて、結果を見て次の一手を決めるというループの基本形は、ReAct という型として整理されています。
3 つ目はツールの設計です。
Anthropic の指針は、エージェントとコンピュータの接点(ACI)の設計に、人間向け UI と同じだけの投資をするよう勧めています。
ツールの説明が曖昧だと、モデルは使い方を試行錯誤し、その分だけトークンと時間が消えていくためです。
同じ指針は「エージェント的なシステムは、タスク性能と引き換えにレイテンシとコストを払うことが多い」とも述べていて、まず単純なプロンプトから始めて評価で最適化し、複雑なエージェントは単純な方法で足りないときだけ足す、という順番を勧めているのです。
コストを下げる仕組みとしてプロンプトキャッシュを整理した記事がありますが、キャッシュが効くかどうかもハーネスがコンテキストをどう並べるかで決まります。
ツールの接続を標準化する MCP も、ハーネスの一部を共通部品にする試みと言えるでしょう。

呼ぶモデルそのものを質問ごとに切り替える考え方も、コストを動かす別の打ち手として整理しています。
最後に
エージェントの良し悪しを語るとき、私たちはつい「どのモデルか」で決めがちです。
けれど同じモデルでも、何を見せ、何を使わせ、いつ止めるかを決めるハーネスで、結果もコストも大きく変わることが公開評価で示されています。
エージェント基盤を選ぶなら、比較軸に「モデル」だけでなく「1 タスクあたりの実測コストと合格率の組」を入れておくのが現実的でしょう。
参考: FrontierHarness Eval/Building effective agents – Anthropic
以上です。



コメントを残す