2026年10月15日、Mistral AI は時系列予測の基盤モデル Timestral を公開しました。
その約1か月前の9月10日には、AWS と Umios(旧マルハニチロ)が、販売計画の予測に Amazon の Chronos-2 を使った事例を共同でブログにまとめています。
どちらも、売上やセンサーの値のように時間の順に並ぶデータ(時系列)を予測するモデルです。
こうしたモデルは、時系列基盤モデル(time series foundation model)と呼ばれます。
大量の時系列で事前学習しておき、初めて見る系列でも追加の学習なしで予測を返すのが特徴です。
従来の予測モデルとの違いと、出力の P10・P50・P90 の読み方が分かると、ニュースの事例が自分の業務に当てはまるかを判断しやすくなります。
従来の時系列予測と何が違うのか
時系列予測は、小売・エネルギー・金融・医療など、多くの分野で計画の土台になっています。
これまでの主流は、ARIMA や ETS のような統計モデルでした。
Chronos の論文は、こうした手法を、系列ごとに別々のモデルを当てはめる「ローカルモデル」と呼んでいます。
深層学習の予測モデルなら、同じデータセットの中の多くの系列をまとめて学ぶことも可能です。
ただし、データセットごとに一から学習するのが普通で、学んだことは新しい分野へ持ち越されないと Mistral の発表も説明しています。
時系列基盤モデルは、さまざまな分野の時系列で一度だけ事前学習し、その知識を新しい系列にそのまま使います。
| 方式 | 学習する単位 | 新しい系列を予測するとき |
|---|---|---|
| 統計モデル(ARIMA・ETS など) | 系列 1 本ごと | その系列の履歴で当てはめ直す |
| 深層学習の予測モデル | データセットごと | そのデータセットで学習し直す |
| 時系列基盤モデル | 多分野の大量の系列 | 履歴を渡すだけで予測する |
参考: Chronos の論文「Chronos: Learning the Language of Time Series」
事前学習とゼロショット予測の考え方
事前学習では、公開されている多分野の時系列や、人工的に作った時系列を大量に読ませます。
Google の TimesFM は、最初の版で実世界の 1,000 億の時点を集めて事前学習したと説明しています。
TimesFM 3.0 では、合成データも含めて 1 兆を超える時点に増えました。
Salesforce の Moirai は、9 分野・270 億を超える観測値を集めたデータセット LOTSA を作り、学習に使っています。
一方で Mistral の Timestral は、学習データの大半が合成データだったと書いています。
予測するときに渡すのは、対象の系列の直近の履歴と、何ステップ先まで予測したいかだけです。
モデルの重みは変えないので、系列ごとに学習の仕組みを用意しなくて済みます。
このように、そのデータで学習せずに予測することをゼロショット予測と呼びます。
Chronos の論文では、学習に使っていない 27 のデータセットで、そのデータで個別に学習した手法と同等か、ときに上回る精度だったと報告されています。
参考: Google Research のブログ「A decoder-only foundation model for time-series forecasting」
LLMの仕組みを流用するモデルもある
時系列基盤モデルの中には、LLM と同じ部品で作られたものがあります。
Chronos は、系列ごとに値の大きさをそろえてから区間に分け、各区間を番号付きのトークンに置き換えます。
その番号の列を、T5 という既存の言語モデルの構造で、次のトークンを当てる学習にかけています。
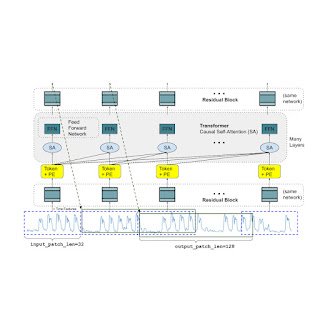
TimesFM は、連続した時点のまとまり(パッチ)を 1 つのトークンとして扱う、デコーダーだけの Transformer です。
Transformer が前の文脈を見て次を決める仕組みは、アテンションの記事で書いています。
ただし、時系列基盤モデルは文章を読み書きするモデルではありません。
Mistral も Timestral を数値のモデルと位置づけ、説明や調査の役は言語モデルのエージェントと組み合わせる構成を示しています。
代表的なモデルと入力・出力
主なモデルを、各社のリポジトリとモデルカードの記載で並べると次のとおりです(2026年10月17日時点)。
| モデル | 開発元 | 公開 | パラメータ数 | 重みのライセンス |
|---|---|---|---|---|
| Chronos-2 | Amazon | 2025年10月 | 1.2 億 | Apache-2.0 |
| TimesFM 2.5 | 2025年9月 | 2 億 | Apache-2.0 | |
| TimesFM 3.0 | 2026年8月 | 3.3 億 | 非商用(商用は Google Cloud 経由) | |
| Moirai 2.0(small) | Salesforce | 2025年8月 | 約 1,100 万 | CC BY-NC 4.0(非商用) |
| Timestral | Mistral AI | 2026年10月 | 500 万〜2.09 億の 4 種 | Modified MIT(条件付き) |
入力の基本は、予測したい系列の履歴です。
Chronos-2・TimesFM 3.0・Timestral は、予測に効く別の系列(共変量)も一緒に渡せます。
共変量には、過去の分だけ分かるもの(来店者数の実績など)と、未来の分も前もって分かるもの(販促の予定・祝日・天気予報など)があります。
出力は、1 つの値を返す点予測と、値の幅を返す分位点の予測の 2 種類です。
TimesFM 3.0 は 10〜90 パーセンタイルの 9 つの分位点を、Timestral は 21 の分位点を返します。
Chronos-2 は、欲しい分位点の水準を呼び出す側で指定します。
次は Chronos の公式 README にある使い方の抜粋で、コメントを日本語にしたものです(手元では実行していません)。
from chronos import Chronos2Pipeline

pipeline = Chronos2Pipeline.from_pretrained("amazon/chronos-2", device_map="cuda")
# 省略: context_df(履歴)と future_df(未来の共変量)を pandas で読み込む
pred_df = pipeline.predict_df(
    context_df,
    future_df=future_df,
    prediction_length=24,             # 何ステップ先まで予測するか
    quantile_levels=[0.1, 0.5, 0.9],  # 返してほしい分位点(P10・P50・P90)
    id_column="id",                   # 系列を見分ける列
    timestamp_column="timestamp",     # 日時の列
    target="target",                  # 予測したい値の列
)
README の描画の例では、結果の表の predictions 列を点予測として、"0.1" と "0.9" の列を予測の幅として描いています。
参考: Chronos の公式リポジトリ(amazon-science/chronos-forecasting)

軽さを売りにするモデルも出てきました。
Timestral は、推論に GPU が要らないとしています。
8 スレッドのサーバー CPU で、15 分刻みの 3 週間分の履歴から 1 日先を予測する場合の時間も公開されました。
かかる時間は、5M のモデルで 10 ミリ秒、209M のモデルで 140 ミリ秒です。
参考: Mistral AI の発表「Introducing Timestral」
P10・P50・P90の読み方
分位点の予測は、「実績がこの値を下回る割合はどれくらいか」で読みます。
AWS の時系列予測サービス Amazon Forecast(新規の受け付けは終了)のドキュメントは、次のように定義しています。
| 分位点 | 実績が予測値を下回る割合 | Umios の事例での呼び方 |
|---|---|---|
| P10 | 10% | 下振れ |
| P50 | 50%(中央値) | 中央 |
| P90 | 90% | 安全側 |
同じドキュメントによると、P10 から P90 の幅には、実績のおよそ 8 割が入る想定です。
幅の広さは、その時点での予測の不確かさの大きさを表しています。
どの分位点を計画に使うかは、外れたときの損の大きさで選びます。
ドキュメントは小売の例として、品切れの損が在庫過多の損より大きいなら、P50 より上の P75 などで予測するほうが役に立つと書いています。
参考: Amazon Forecast のドキュメント「Evaluating Predictor Accuracy」
業務では人が確かめて確定する
Umios の事例は、分位点の予測を人の判断とどう組み合わせるかの具体例になっています。
同社では全国の支社の営業担当者が毎月、販売計画を手で入力していて、業務用流通事業部の全支社で年に約 4,200 時間かかると試算していました。
最初は、社内の生成 AI チャット(Claude Sonnet 4 ベース)で需要予測を試していました。
しかし、LLM による予測には、再現性とシステムへの組み込みの面で課題がありました。
同じデータで Chronos-2 と比べると Chronos-2 のほうが精度が高く、本格的な PoC に進んでいます。
運用の流れは次のとおりです。
- Chronos-2 が P10・P50・P90 を出し、下振れ・中央・安全側の 3 つの値として示す
- 支社の計画策定担当者が 10 日間の確認期間で点検・修正し、最終的に確定する
- 予測は日次で更新し、BI ツールで予測・計画・実績を並べ、予測と計画の乖離をアラートで知らせる
仕組みは、SageMaker JumpStart 上の Chronos-2 を Step Functions と EventBridge で毎日動かし、実績と予測結果を S3 に置く構成でした。
ブログには、AI は「たたき台」を出し、確定の責任は人が持つという分担を事業部と合意したことが、現場の受け入れにつながったとあります。
PoC で対象にした定番品では、年の累計の合計で 95% の予測精度が出ました。
全商品に広げた場合は、年 4,200 時間の作業削減を見込んでいます。
一方で「Chronos-2 は予測の結果しか返さない」という現場の声もありました。
そのため、予測結果の考察を言葉で返すエージェントを Amazon Bedrock AgentCore で作る予定が示されています。
数値の予測と、その説明とを、別の仕組みに受け持たせる考え方です。
参考: AWS ブログ「Umios(旧マルハニチロ) が時系列基盤モデル Chronos-2 で実現する販売計画 AI」

向かない場面と落とし穴
事前学習で多くの系列を見ていても、モデルは自分のデータの事情までは知りません。
公開資料から読み取れる注意点は、次の 4 つです。
実績は需要と同じではない
販売実績は「売れた量」で、「本当の需要」とは限りません。
Umios の事例では、在庫を処分するために 100 円の商品を 20 円で売った日の急な伸びを、学習データから外しています。
残したままだと、同じ急増が将来も繰り返すとモデルが受け取ってしまうためです。
規格変更のたびに JAN コードが変わり、ある冷凍食品では履歴が 5 世代に分かれていた例も報告されました。
ブログは、予測を始める前のマスターデータの整備が精度を大きく左右することを、学びとして挙げています。
外部要因と構造の変化
履歴だけを見るモデルは、販促や祝日のような外からの影響を知りません。
Chronos-2 の技術報告も、それまでのモデルが単変量の予測に偏り、実務で使える場面を狭めていたと書いています。
Umios の事例でも、毎年 2〜4 月にピークが来る季節品では周期を捉えきれず、WMAPE(誤差の割合を示す指標で、小さいほど良い)が 62.57% でした。
月を表す列を特徴量に足すと WMAPE は 20% まで下がり、使う履歴を 1 年から 3 年に広げたことも季節品の精度を上げています。
市場の局面が変わる、設備が劣化するといった理由で、データの性質そのものが動くこともあります。
Mistral は、そうした変化に合わせて自社のデータで追加学習し、学習し直し続けられることに価値があるという立場です。
初代の Chronos の論文には、履歴が短いとトレンドを小さく見積もる例や、指数関数的な伸びを予測しきれない例も載っています。
評価は自分のデータで過去に戻って測る
発表に書かれたベンチマークの順位は、新しいモデルが出るたびに入れ替わります。
Chronos-2 は 2025年10月の公開時に、GIFT-Eval などで事前学習モデルの最高精度とされました。
1 年後の Timestral の発表では、28M のモデルが GIFT-Eval と TIME で Chronos-2 を上回ったとされています。
自分の業務に合うかは、過去のある時点までの履歴だけを渡して予測させ、その後の実績と比べるバックテストで確かめます。
点予測の外れ具合(WAPE など)に加えて分位点の外れ具合(wQL など)も見ると、幅が信用できるかまで分かります。
もう 1 つの注意は、評価に使うデータが事前学習に含まれていないかどうかです。
Chronos-2 は、GIFT-Eval のテスト部分と重なるデータを学習から外したとモデルカードに明記しています。
ライセンスはモデルごとに違う
重みを自分の環境で動かすときは、ライセンスを必ず読みます。
Chronos-2 と TimesFM 2.5 は Apache-2.0 ですが、TimesFM 3.0 の重みは非商用・非本番の利用に限られます。
TimesFM 3.0 を商用で使えるのは、BigQuery ML などの Google Cloud のサービス経由の場合です。
Moirai 1.1 と 2.0 の重みも CC BY-NC 4.0 で、非商用の条件が付いています。
Timestral の Modified MIT ライセンスは、前月の連結の月間売上が 2,000 万ドルを超える企業と、その企業に勤める人には利用を認めていません。
参考: TimesFM の公式リポジトリ(google-research/timesfm)
重みが公開されていることと、自由に使えることは別の話です。
オープンウェイトとオープンソースの違いや、利用条件の読み方は次の記事で書いています。
最後に
時系列基盤モデルは、多分野の時系列で事前学習しておき、履歴を渡すだけで点と幅の予測を返すモデルです。
系列ごとにモデルを作る手間は減りますが、学習データの選び方・外部要因・評価・ライセンスの判断は使う側に残ります。
P10〜P90 の幅で不確かさを示し、確定は人が行うのが、Umios の事例に見られる使い方です。
まずは手元の過去データでバックテストを回し、幅の中に実績がどれだけ入るかを確かめるところから始められます。
以上です。

コメントを残す