新しい AI モデルの発表で、「オープンウェイトで公開」という言い回しを見かける機会が増えました。
例えば Xiaomi は 2026年9月22日、MiMo-V2.6 というモデル群をMIT ライセンスのオープンウェイトとして Hugging Face に公開しています。
「オープン」と付いているなら、オープンソースと同じように自由に使えるはず、と受け取ったことはありませんか?
実はこの言葉には、何を公開したかと、どこまで使ってよいかが別々に決まるという落とし穴があります。
オープンウェイトモデルは「学習済みの重み」を配るモデル
AI モデルの重み(パラメータ)とは、学習によって決まった膨大な数値の集まりのことです。
非営利団体 Open Source Initiative(OSI)の The Open Source AI Definition 1.0 は、重みを「入力から出力を生み出す学習済みパラメータの集合」と説明しています。

料理にたとえるなら、重みは焼き上がったケーキで、学習データと学習用のコードは材料とレシピにあたるでしょうか。
オープンウェイトは、ケーキは配るけれど、材料とレシピまで配るとは限らないという公開の仕方です。
API でしか使えないクローズドなモデルとの違いは、ファイルそのものが手元に届くことです。
自分の PC やサーバーで動かせるうえ、追加で学習させて作り替えることもできます。
冒頭の MiMo-V2.6-Pro-RL のモデルカードでも、案内は重みの配布先、技術レポート、動かすための手順までにとどまります。

学習データや学習コードの公開は、2026年9月23日の確認時点で記載が見当たりませんでした。
オープンソースAIとの違いは「作り直せるかどうか」
オープンソースAIの条件を定めるため、OSI が Open Source AI Definition の 1.0 版を発表したのは 2024年10月28日です。

定義はまず、使う・仕組みを調べる・改変する・共有するという四つの自由を掲げています。
その前提として求められるのが、次の三つがそろった「改変に適した形」です。
- データ情報: 熟練者が実質的に同等のシステムを作れるほど詳しい、学習データの情報
- コード: 学習と実行に使った完全なソースコード
- パラメータ: 重みなどの設定値
さらに定義は、「オープンソースの重み」を名乗るなら、その重みを導き出したデータ情報とコードも含むべきだと明記しています。
つまり、重みだけの公開は、どれほど寛容なライセンスでも、この定義のオープンソースAIにはあたらないということです。
対照的な例が、Allen Institute for AI の OLMo 2 のモデルカードです。

学習に使ったデータセットやコード、途中段階のチェックポイントまで公開していると案内されています。
重みだけでは、モデルの振る舞いの理由を学習データまでさかのぼって確かめるのが難しいわけです。
ライセンスは「何を許し、何を条件にしているか」を読む
同じオープンウェイトでも、できることはライセンス次第で大きく変わります。
寛容型の MIT と Apache 2.0
MIT ライセンスの条件は、ほぼ「著作権表示と許諾表示を、すべての複製に含めること」だけです。
Apache License 2.0 は表示の保持に加えて、変更したファイルにその旨を示すことや、NOTICE ファイルの引き継ぎを求めます。
特徴的なのが特許の扱いで、貢献者から特許の利用許諾を受けられる一方、特許訴訟を起こすとその許諾が終了する仕組みです。
利用条件つきの独自ライセンス
開発元が独自に定めたライセンスの代表例が Llama 3.1 のコミュニティライセンス(2024年7月23日公開版)で、次のような条件が並びます。
- 月間アクティブユーザーが7億人を超える場合は、Meta に別途ライセンスを申請する
- 製品やサイトなどに「Built with Llama」と目立つように表示する
- Llama をもとに作ったモデルの名前は、先頭に「Llama」を付ける
- 別文書の利用ポリシーに従う
Google の Gemma Terms of Use も禁止用途のポリシーを参照しており、派生モデルを配るときにもその利用制限を契約に含めるよう求めているのが特徴です。
読むべき条項のチェックリスト
ライセンス名だけで判断せず、原文で次の点を確かめておくと安心です。
- 商用利用できるか(非商用に限るライセンスもある)
- 利用者の規模による制限や、表示・命名の義務はないか
- 別文書の利用ポリシーで禁止用途が定められていないか
- 元にしたベースモデルのライセンスは何か
最後の項目が効くのは、派生モデルにもベースモデルの条件がついて回ることがあるからです。
例えば MiMo-V2.6-Distill-Qwen-9B は MIT ですが、モデルカードの base_model 欄をたどると、元は Apache 2.0 の Qwen3.5-9B だと分かります。

手元で使うときの使いどころと注意
重みが手元にあると、API では難しい使い方にも道が開けます。
- データを外部のサーバーに送らずに、手元で動かす
- 自分のデータで追加学習(ファインチューニング)する
- 量子化して、少ないメモリで動く形に軽くする
- 大きなモデルの出力を教材に、小さなモデルを鍛える(蒸留)
手元で試す入口としては、Windows で Ollama を使う手順も別の記事で紹介しています。
メモリは「総パラメータ数」で見積もる
最初にぶつかるのが、重みを載せるだけで必要になるメモリの大きさです。
目安は、パラメータ数に1個あたりのバイト数を掛けた値です。
16ビット(2バイト)なら 9B のモデルで約18GB、4ビットに量子化すれば約4.5GB という計算で、実際にはこれに作業用の領域が加わります。
量子化の仕組みと精度への影響は、こちらにまとめました。

トークンごとに一部の「専門家」だけを使う MoE という構造のモデルは、見積もりに注意が要ります。
Hugging Face の解説記事 Mixture of Experts Explained は、計算に使うのは一部でも、すべての専門家をメモリに載せる必要があると説明しています。
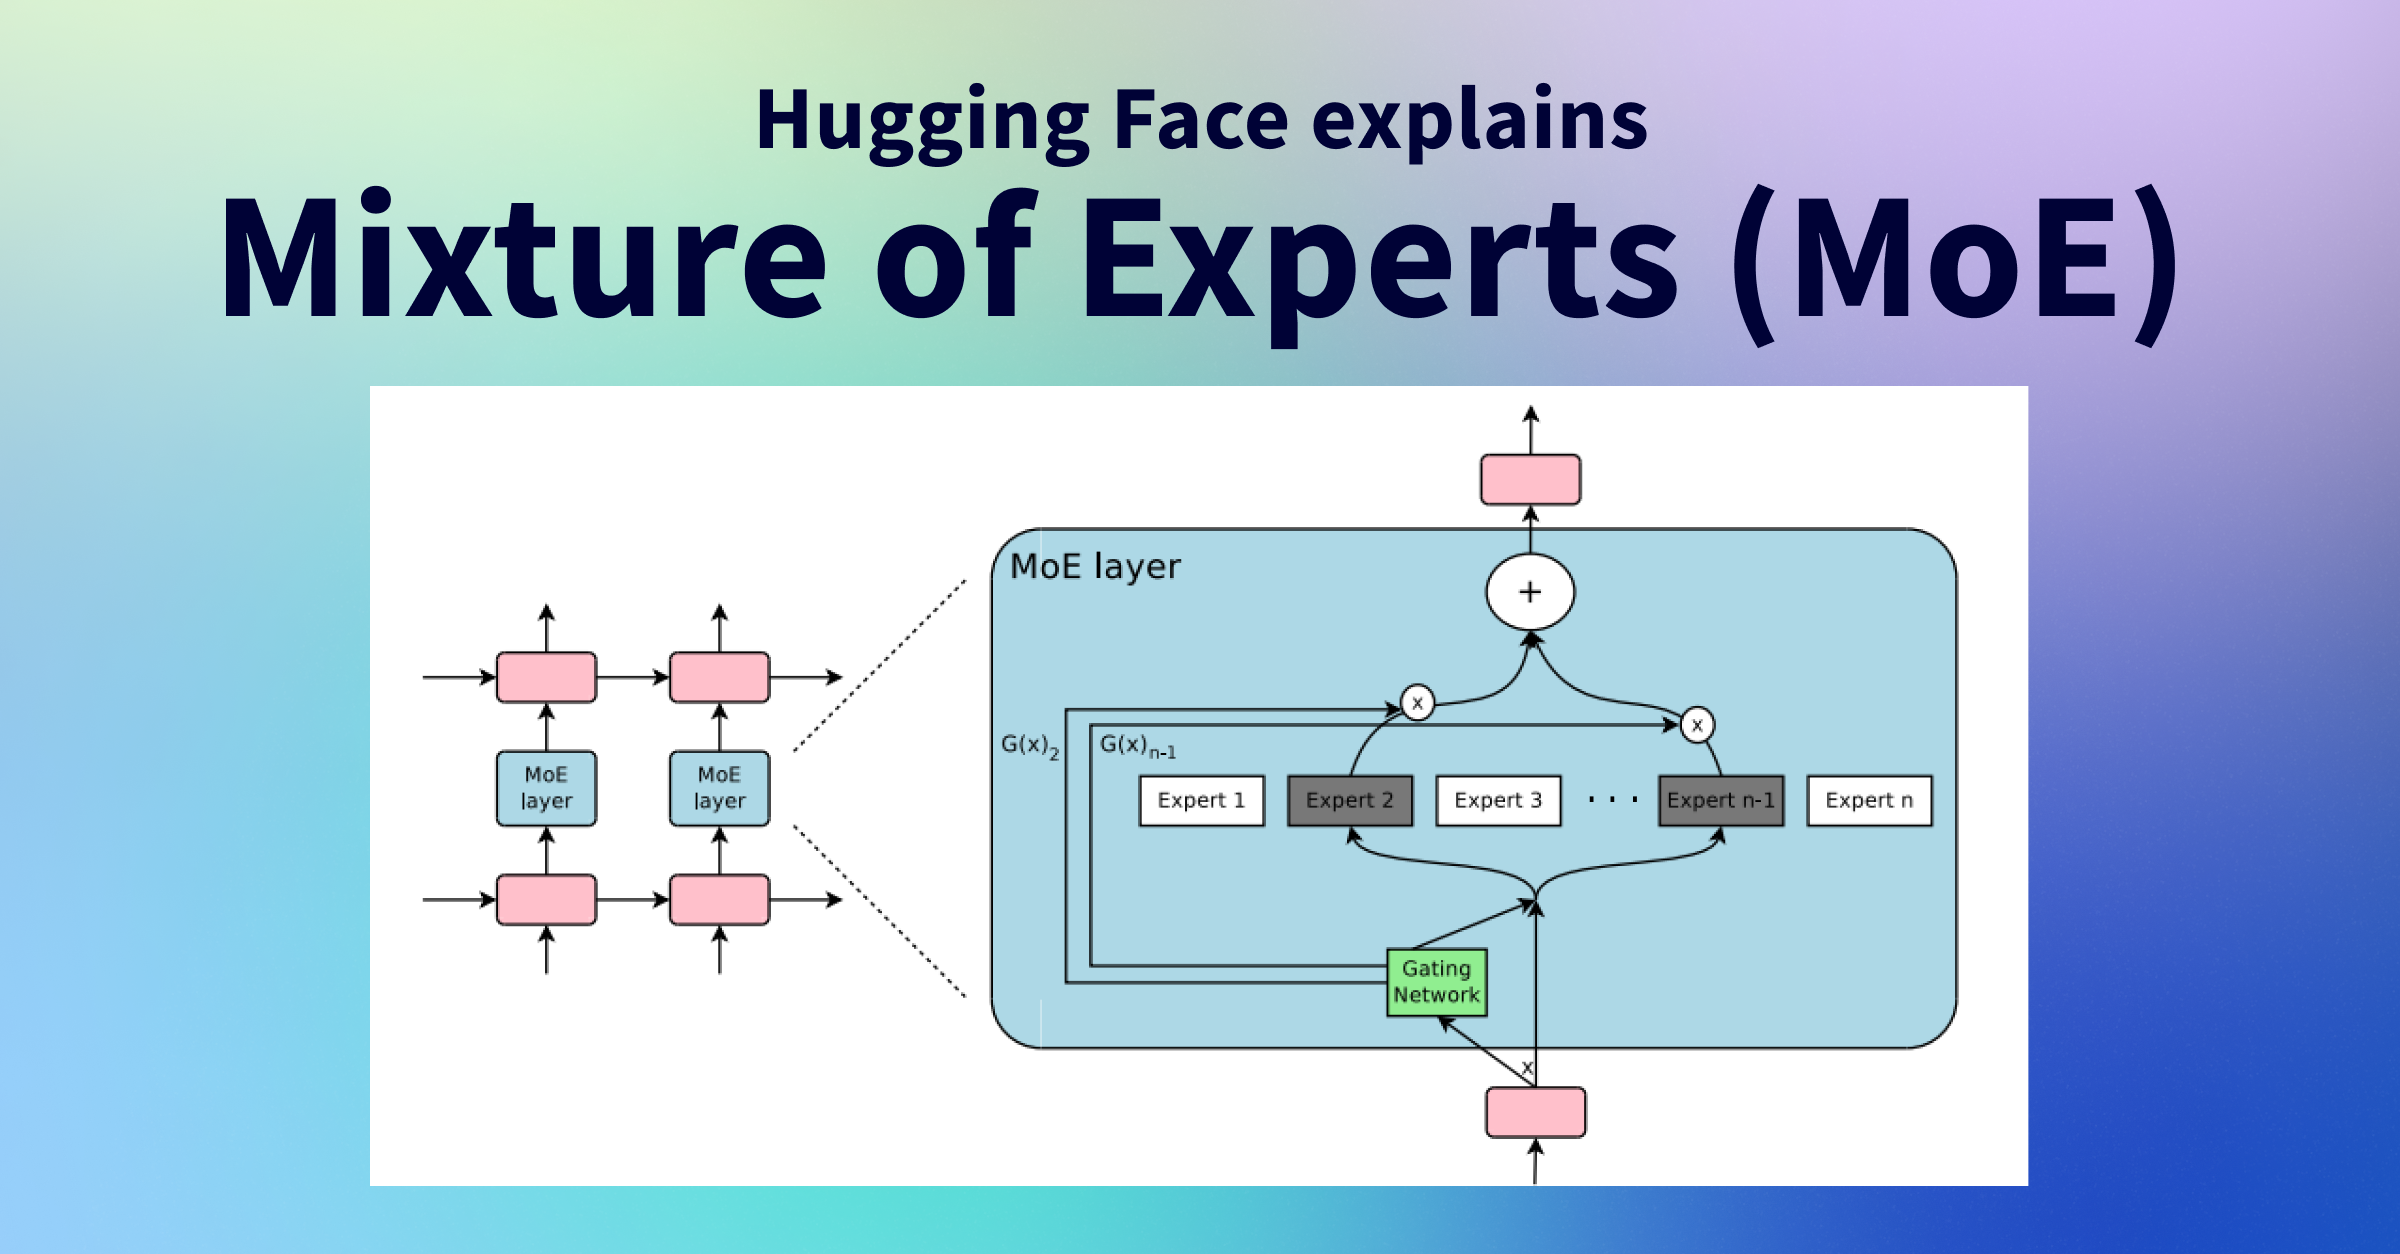
総パラメータ 1.02T・アクティブ 42B の MiMo-V2.6-Pro-RL なら、16ビットで単純計算すると約2TB です。
安全対策は使う側の仕事になる
API 経由なら提供側がサーバーで入出力の検査を挟めますが、手元で動かすときはその仕組みが届きません。
米国の電気通信情報局(NTIA)が 2024年7月30日に公表した報告書も、公共の安全に関する章で重みに直接触れられれば安全機能を取り除けてしまう点を指摘しています。
Llama 2-Chat 13B の安全機能を、性能を保ったまま外す費用が200ドル未満だったという報告も挙げられていました。
もっとも報告書全体の結論は、現時点では重みの公開を制限せず、リスクの監視を続けるべきというものでした。
入力と出力のチェック(ガードレール)を自分で用意するところまでが利用者の役目だと考えておくとよいでしょう。
最後に
オープンウェイトモデルは、学習済みの重みを配る公開の仕方で、作り直せることまで含むオープンソースAIとは別物です。
ライセンスにも、MIT のような寛容型から条件つきの独自ライセンスまで幅があります。
新しいモデルを見かけたら、モデルカードの license 欄とライセンス原文、それに総パラメータ数を先に確かめると、使えるかどうかの判断が早くなるでしょう。
私自身も学んでいる途中なので、気になるモデルが出たら同じ手順で確かめていきます。
以上です。



コメントを残す