Wheel of Misfortune は、Google の SRE チームが続けてきた障害対応の机上訓練の呼び名です。
本番では何も壊さず、過去の障害や起こりうる壊れ方を題材にして、当番役が何を確かめて何をするかを声に出して進めます。
本番を壊す演習より軽い準備で、当番に入る前の練習を始められるところが、ほかの訓練との違いです。
Google の SRE 本と SRE ワークブック、英国政府の GOV.UK PaaS チームが公開した記録を読むと、誰がどの役を持ち、何を用意し、どこでつまずきやすいかまで分かります。
私も SRE を学んでいる途中なので、ここに書くのは公開資料を読んで整理した内容です。
当番の人数やシフトの組み方は、オンコール運用の設計の回で扱いました。
Wheel of Misfortune は障害を起こさずに当番を演じる訓練
Google の SRE 本『Site Reliability Engineering』の第 28 章「Accelerating SREs to On-Call and Beyond」は、新しく入った SRE を当番に送り出すまでの育て方を扱う章です。
その中の「Disaster Role Playing」の節が、障害のロールプレイを「Wheel of Misfortune」や「Walk the Plank」という呼び名で紹介しています。
おどけた名前が付いているのは、入ったばかりの人が身構えずに参加できるようにするためだそうです。
形はテーブルトーク RPG に近く、進行役のゲームマスター(GM)がメンバーから 2 人を選んで、プライマリとセカンダリの当番役にします。
呼び出しが鳴ったと告げられたら、当番役は影響を抑える手と原因を調べる手を口で答え、GM がその結果どうなったかを返していきます。
1 回は 30〜60 分ほどで、うまく回っているチームでは毎週の習慣になるとされています。
参考: Site Reliability Engineering, Chapter 28 – Accelerating SREs to On-Call and Beyond
同じ章は当番を目指す人のための練習を 5 つ挙げていて、障害のロールプレイはそのうちの 1 つです。
- ポストモーテムを読み、チームで共有する
- 障害をロールプレイする(Wheel of Misfortune)
- 本番から切り離した環境を壊して直す
- 当番向けの学習リストを読み、古くなった節を書き直す
- 早いうちからシャドーで当番に付く
このうち 3 つの訓練で、何を題材にして何を壊すのかを並べると、次のようになります。
| 訓練 | 題材 | 何を壊すか |
|---|---|---|
| 障害のロールプレイ | 過去の障害や、起こりうると仮定した障害 | 何も壊さない |
| 壊して直す演習 | 設定の誤り・メモリリーク・性能の劣化など | 本番の通信から外した環境や検証用の環境 |
| シャドーの当番 | 本物の呼び出し(当番役ではないので時間に追われない) | 何も壊さない |
本番のシステムに管理された障害を起こす DiRT やカオスエンジニアリングの実験とも、何も壊さないところが違います。
本番で障害を起こして確かめるほうの実験は、カオスエンジニアリングの回にまとめてあります。
机上で練習する理由は、静かすぎる当番と準備の重さ
当番が静かすぎるのも困りものだと、SRE 本の第 11 章「Being On-Call」は述べています。
本番から長く離れると自信が過剰にも過小にもなり、知識の穴は障害が起きて初めて見つかるからです。
その対策として、各自が当番に入る回数を確保することと並んで、Wheel of Misfortune がトラブルシューティングの腕とサービスの知識を磨く活動に挙げられています。
参考: Site Reliability Engineering, Chapter 11 – Being On-Call
SRE ワークブック(『The Site Reliability Workbook』)の第 8 章「On-Call」も、呼び出しの原因を突き止めるまでの遅れを縮める手の 1 つに、この訓練でデバッグのやり方を同僚と共有することを入れていました。
同じ章には、3 か月以内に当番に入る必要があった Google の新しい SRE チームの例も載っています。
Google の SRE チームの多くは、新しく入った人が当番に入れるまでに 3〜9 か月を見込んでいるそうです。
このチームは最近の障害をロールプレイで再現して本番のデバッグを練習し、立ち上がった後も進行役を持ち回りにして続け、記録も残しました。
参考: The Site Reliability Workbook, Chapter 8 – On-Call
もう 1 つの理由は、準備の重さです。
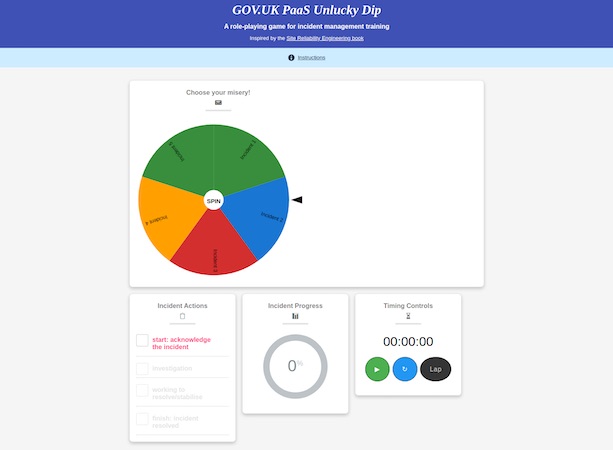
GOV.UK PaaS チームは本番の複製環境でゲームデーを開いていましたが、準備に数日、実施に丸 1 日かかり、頻繁には回せませんでした。
2021 年 3 月の記事では、Google の Wheel of Misfortune を手本にした、複製環境の要らないワークショップを初めて開いたと報告しています。
リモートで働いていても回せることと、当番のローテーションに加わる人の訓練に使えることも、狙いに入っていました。
最初の回の準備には少し時間がかかるものの、その後は頻繁に回しながらシナリオを足していけるというのが、このチームの振り返りでした。
参考: Wheel of Misfortune: Incident rehearsal for GOV.UK PaaS
進め方はシナリオ・役・語り・振り返りで組む
公開資料を並べると、準備から終わりまでは 4 つの要素に分けて考えられます。
シナリオは過去の障害と、これから起こりうる壊れ方から選ぶ
第 28 章は、シナリオの元として次の 3 つを挙げています。
- 新しいメンバーがいなかった頃の障害や、古いメンバーが忘れかけた障害
- 新しい機能やリリース前の機能が壊れたと仮定した障害(全員が同じように不慣れになる)
- 同僚が本番で見つけたばかりの新しい壊れ方
過去の障害を題材にするときの元はポストモーテムで、同じ章はポストモーテムが次の訓練の燃料にもなると述べています。
ポストモーテムの書き方そのものは、Tech Lead の連載で扱いました。
SRE ワークブックの第 9 章「Incident Response」も、訓練の障害は一から作ってもよく、ポストモーテムから起こしてもよいとしています。
GOV.UK PaaS では技術リードがサービスの壊れ方を洗い出し、直し方と利用者への影響を一緒に書き出してから、影響をもとに練習する順を決めました。
役は GM と当番役 2 人を基本にする
基本の役は、シナリオを用意して進める GM と、プライマリとセカンダリの当番役 2 人です。
ほかのメンバーは周りで見る立場ですが、ワークブックの例では全員が解き方の案を出すよう促されていました。
GOV.UK PaaS は普段の働き方に合わせてチーム全員で解く形にし、PaaS を使うサービスの持ち主への連絡を受け持つ役も、途中から加えています。
Google の『Building Secure and Reliable Systems』第 16 章「Disaster Planning」は、同じ形の机上演習に経営層や広報、法務の担当まで加えられるとしています。
参考: Building Secure and Reliable Systems, Chapter 16 – Disaster Planning
GM は監視画面の代わりに状況を語る
当番役の前には本物の画面が無いので、GM がダッシュボードのグラフがどう見えるかを言葉で補います。
別のチームに上げる場面では、GM がそのチームの人を演じます。
話が的外れな方向へ進んだときは、GM が新しい情報を足したり、急ぎの問いを投げたりして引き戻します。
第 28 章の脚注にある投げ方の例は、「別のチームから呼び出しが来て、追加の情報が届いた」と「お金がどんどん失われている、短期的に止めるにはどうするか」の 2 つです。
『Building Secure and Reliable Systems』は、60 分の机上演習に 10〜20 ほどの判断の分かれ道を用意し、ログや利用者からの報告、アラートのような実物に近い資料も作っておくよう勧めています。
選んだ手がその後の展開を変えるのも特徴で、乗っ取られたメールサーバーを止めると決めたら、その後はメールで知らせることができません。
終わったら判断の理由と直すことを残す
GOV.UK PaaS は記録係を 1 人置き、会話と判断の理由を後から見返せるようにしました。
SRE ワークブックの第 9 章は、訓練のたびに、うまくいったこと・いかなかったこと・どうすればよかったかを報告にまとめると、訓練の効果が上がるとしています。
同じ章は、訓練でいちばん価値があるのは結果を見直すことで、そこから対応の穴が見えてくるとも書いていました。
参考: The Site Reliability Workbook, Chapter 9 – Incident Response
『Building Secure and Reliable Systems』も、改善の提案を具体的に出したうえで、担当者の決まった作業項目にするよう求めています。
机上訓練で外しやすい落とし穴
原典を読むと、机上の訓練ならではの外し方がいくつか見えてきます。
本物の障害や演習の代わりにしてしまう
第 28 章は、どれだけ仮の障害で練習しても、それだけで当番の準備が整うことはないと書いています。
同じ章は、本番から切り離した環境を壊して直す経験のほうがさらに良いとし、シャドーで本物の呼び出しを受ける段階も続けて置いていました。
障害のロールプレイは、新人の頭を障害対応に慣らすための入り口という扱いです。
正解を当てるテストにしてしまう
第 28 章が目指しているのは、毎回、参加した全員が何かを学ぶことです。
新しいツールや別の解き方を知ることも、新人が「自分が指名されても解けた」と確かめられることも、成果に数えられています。
『Building Secure and Reliable Systems』も、参加者が打ちのめされた気持ちのまま終わらせず、うまくいった点とそうでない点を振り返って締めるよう書いていました。
進行役がサービスを知らない
GOV.UK PaaS は、あらゆる展開を事前に書き尽くすのは難しく、進行側にサービスの技術に詳しい人を置いて、詰まったときに導けるようにする必要があったと振り返っています。
『Building Secure and Reliable Systems』も、進行役がシナリオを読み込んでおけば、その場で即興しながら正しい方向へ押せると述べています。
口で答えるだけで、手順や道具に触らない
『Building Secure and Reliable Systems』は、どう対応するかを話し合うだけで終わらせず、実際にやって見せることを求めています。
たとえば手順書がフォレンジックとネットワークの担当への連絡を求めているなら、訓練の中でも実際にその連絡を行います。
対応を手でなぞることが、体で覚えることにつながるという考え方です。
SRE ワークブックの第 9 章も、訓練ではできるだけ本物のツールを使うよう勧めていました。
手順書そのものの書き方は、ランブックの回で扱っています。
最後に
Wheel of Misfortune は、過去の障害や起こりうる壊れ方を題材に、GM が状況を語り、当番役が判断を口にしていく机上の訓練です。
本番を壊さず準備も軽いので、当番に入る前の練習にも、静かすぎて本番から遠ざかったチームの手入れにも使えます。
ただし本物の障害や壊して直す演習の代わりにはならず、終わった後に結果を見直し、直すことを決めるところまでが訓練です。
当番の仕組みを作り始めたチームなら、手元のポストモーテムを 1 本選んで、30 分の回を開くところから試せます。
以上です。

コメントを残す