MCP サーバーにツールを 11 個登録したら、AI が 20 問中 8 問で違うツールを呼んだ、という記録が 2026 年 10 月 28 日に Qiita で公開されました。
書いたのは自作の MCP サーバーを作っている開発者で、ツールの説明文と数を見直したあとは 20 問中 19 問を正しく選べたそうです。
エラーは 1 件も出ておらず、単体テストもすべて通っていました。
壊れていたのはコードではなく、ツールに付けた説明文(description)の書き方でした。
AI がツールを選ぶときに何を見ているのかが分かると、説明文に何を書けばよいかも決まります。
MCP そのものの仕組み(サーバーとクライアントがツールをやり取りする流れ)は、別の記事で整理しました。
選び間違いはエラーにならない
まずは元の記録の中身を、数字のまま追います。
MCPサーバーにツールを11個渡したらAIが4割使い間違えた(Qiita)

著者はノートを保存するデータベースを MCP で AI につなぎ、検索・取得・作成・削除などのツールを 11 個用意しました。
「最近のノートを一覧して」と頼むと、AI はノートの全文を返す fetch_all_raw を呼び、1 万 2 千行が会話に積まれて応答まで 40 秒かかったと書かれています。
Claude Desktop から日常で使いそうな依頼を 20 問投げて手で採点すると、正しく選べたのは 12 問でした。
間違えた 8 問のうち 5 問が fetch_all_raw で、説明文は「検索」「ノート」のような 2〜3 文字だったそうです。
ツール自体は頼まれたとおりに動くので、テストでは見つかりません。
選び間違いは、実際の会話の中でだけ起きる不具合だという点が、この記録のいちばん怖いところでした。
モデルが見ているのは名前と説明文だけ
AI がツールの中身のコードを読んで選んでいるわけではありません。
MCP の仕様では、サーバーが渡すツールの定義は name・title・description・inputSchema・outputSchema・annotations などの項目でできています。
Tools(Model Context Protocol 仕様 2026-07-28 版)

仕様の型定義では、description は「モデルへのヒントのようなもの」で、クライアントが利用可能なツールを LLM に理解させるために使うと書かれています。
Schema Reference(Model Context Protocol)
さらに MCP のツールは「モデルが制御する」ものと位置づけられていて、どれを呼ぶかは会話の文脈からモデルが決めます。
モデルの手元にあるのは名前と説明文と引数の形だけなので、説明文がツールを選ぶための唯一の手がかりになります。
「検索」の 2 文字しか無ければ、名前の似たツールのどれに流れても不思議ではありません。
説明文に書く4つのこと
何を書けばよいかは、Anthropic の Claude API ドキュメントがはっきり挙げています。
Define tools(Claude API Docs)
このページは、詳しい説明文を「ツールの性能でずば抜けて重要な要素」と呼び、次の 4 つを書くよう勧めています。
- ツールが何をするか
- いつ使うべきか(そして、いつ使うべきでないか)
- 引数それぞれの意味と、結果への影響
- 注意点や限界(名前から分かりにくいときは、何を返さないか)
分量の目安は、1 つのツールにつき少なくとも 3〜4 文です。
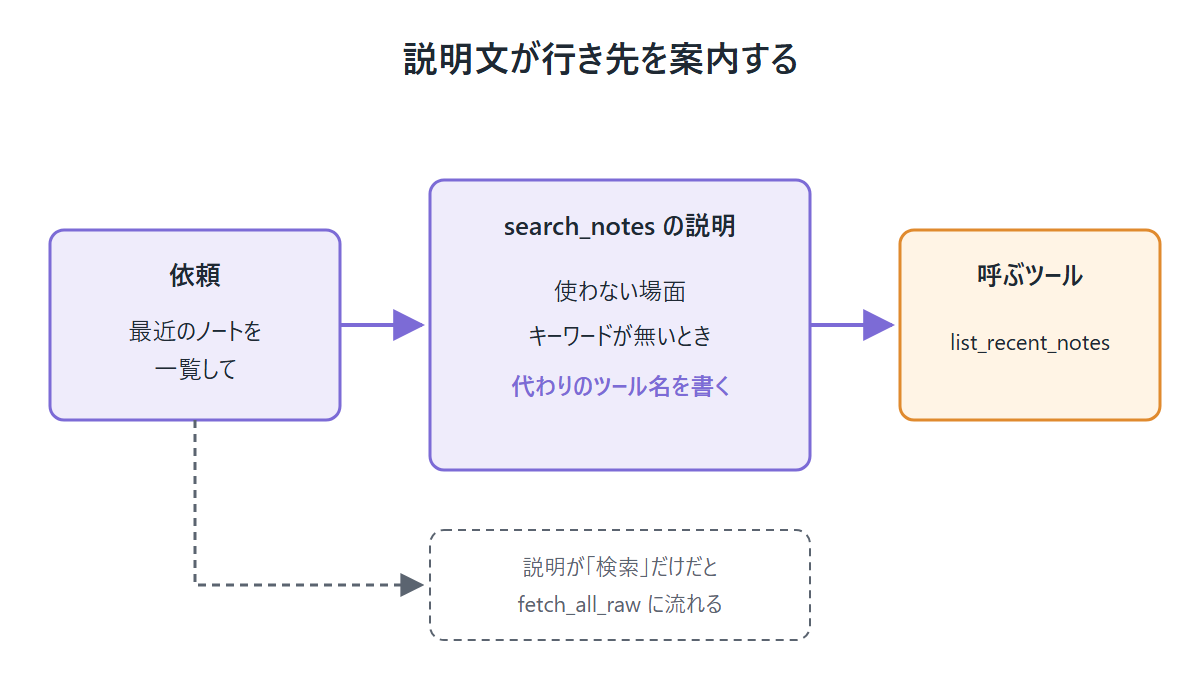
Qiita の著者がいちばん効いたと書いているのは、2 つ目の「使わない場面」に代わりのツール名まで書く型でした。
たとえば検索のツールに「キーワードが無く最近のノートが欲しいだけなら list_recent_notes を使う」と書いておくと、説明文そのものが行き先の案内として働きます。
次の定義は、この 4 つを MCP のツールの形に当てはめた例で、説明のために作ったものです。
{
  "name": "search_notes",
  "description": "キーワードでノートを探し、id・タイトル・更新日を1件1行で返す。本文は返さない。キーワードが決まっているときに使う。キーワードが無く最近のノートを見たいだけなら list_recent_notes を使う。本文が要るときは、ここで得た id を get_note に渡す。例: query=\"RAG 検索精度\", limit=5",
  "inputSchema": {
    "type": "object",
    "properties": {
      "query": { "type": "string", "description": "探す語。空文字は不可" },
      "limit": { "type": "integer", "description": "返す件数の上限。既定は5" }
    },
    "required": ["query"]
  },
  "annotations": { "readOnlyHint": true }
}
名前と引数の例で迷いを減らす
説明文の次に効くのが、ツールの名前と引数の書き方です。
Qiita の記事は、名前を「動詞_目的語」の形にそろえることと、説明文に引数の例を 1 行書くことを型に入れています。
fetch_all_raw のような名前は「取得」なのか「全件取得」なのかが読めず、get_note との違いも伝わりませんでした。
Anthropic のエンジニアリングブログも、引数名を曖昧にしないよう勧めていて、user ではなく user_id にする例を挙げています。
Writing effective tools for AI agents(Anthropic)
複数のサービスのツールを並べるときは、github_list_prs のようにサービス名を頭に付けると選び分けやすくなる、と Claude API のドキュメントは書いています。
MCP の仕様も、名前が一意なのは 1 つのサーバーの中だけで、複数のサーバーを束ねると search のような名前がぶつかりうると注意しています。
引数の例については、Claude API には定義に例を載せる input_examples という項目があります。
一方で MCP のツールの定義には例を入れる専用の項目が無いので、説明文か、inputSchema の各引数の説明に書くしかありません。
重なるツールと全部返すツールを作らない
説明文を直しても、役割の重なるツールが並んでいれば迷いは残ります。
Anthropic のブログは、機能が重なっていたり目的があいまいだったりすると、エージェントはどれを使うかで混乱すると書いています。
勧めているのは、どのツールにもはっきりした別々の目的を持たせることです。
Qiita の例では、全文を返す fetch_all_raw と、全件を書き出す export_notes が「一覧」の依頼にどちらも当てはまっていました。
全部を返すツールには、もう 1 つ別の問題もあります。
同じブログは連絡先の例で、全件を返すツールを使うとエージェントが関係の無い情報で限られたコンテキストを使い切ってしまうと説明し、list_contacts より search_contacts を作るよう勧めています。
ブログによると、Claude Code はツールの応答を既定で 25,000 トークンまでに制限しているそうです。
Qiita の著者も全文ダンプのツールを消していて、平均の応答時間は 28 秒から 4 秒に縮んだと報告しています。
なお、ツールのまとめ方には別の流儀もあります。
Claude API のドキュメントは、create_pr・review_pr・merge_pr を別々に作るより、action という引数を持つ 1 つのツールにまとめるよう勧めています。
「1 ツール 1 責務」とは逆に見えますが、どちらも選択肢の重なりを減らしてモデルを迷わせない、という同じ方向の助言です。
ツールの数はどこから効いてくるか
Qiita の著者は、読み取りのツールを 5 個までに削り、書き込みのツールは普段つながない別のサーバーに分けました。
数の目安として、Claude API のツール検索のドキュメントは、使えるツールが 30〜50 個を超えると Claude が正しいツールを選ぶ力が落ちると書いています。
Tool search tool(Claude API Docs)
同じページは、ツールが 10 個以上あるときにはツール検索を使う候補になるとしています。
Qiita の例は 11 個で 4 割を間違えていて、この目安よりずっと少ない数でも選び間違いは起きています。
ただし、Qiita の改善は「ツールを 11 個から 5 個に減らす」と「説明文を書き直す」を同時に行っています。
20 問という少ない問題数を手で採点した結果でもあるので、どちらがどれだけ効いたかまでは切り分けられていません。
書き込みのツールを分ける考え方は、仕様の annotations にも表れています。
MCP には、環境を変えないことを示す readOnlyHint や、破壊的な変更をしうることを示す destructiveHint などがあります。
ただし仕様は、これらをあくまでヒントとし、信頼できないサーバーから来た値でツールの扱いを決めてはいけないと定めています。
直したかどうかを確かめる
説明文の良し悪しは、読んだだけでは判断できません。
Anthropic のブログは、評価を作ってツールの性能を測ることを勧めていて、API を直接呼んでプログラムで回す方法を挙げています。
同じブログには、説明文の小さな手直しでも劇的に良くなることがあると書かれています。
Qiita の著者は、20 問の依頼文と正解のツールを用意し、直す前と後で正答数を比べました。
あわせて、名前の形や「使わない場面」「例」が説明文に入っているかを AST で検査するスクリプトを作り、コミットのたびに回しているそうです。
手元で始めるなら、よく頼む依頼を 20 個ほど書き出し、それぞれに正解のツール名を付けておくだけでも、直した効果を数字で見られます。
最後に
AI はツールのコードを読まず、名前と説明文だけを見て選びます。
説明文には、何をするか・いつ使うか・いつ使わずに何を使うか・何を返さないかを書き、重なるツールと全部返すツールは作らないようにします。
使わない場面と代わりのツール名を書いておくと、説明文がそのまま行き先の案内になります。
MCP サーバーを作るときは、機能を足す前に、ツールの一覧と説明文を一度見直してみてください。
以上です。

コメントを残す