AI エージェントの話題で「マルチエージェント」という言葉を見かける機会が増えました。
1 つのエージェントに全部を任せるのをやめて、複数のエージェントに仕事を分けて持たせる構成のことです。
Claude Code のサブエージェントのように手軽に分けられる道具も増えましたが、分ければいつも得をするわけではありません。
仕組みと、性能とコストの関係が分かると、どんな仕事で分けるべきかの判断がしやすくなります。
マルチエージェントは仕事を分けて持たせる構成
マルチエージェントは、複数の AI エージェントが役割を分担して 1 つの仕事を進める構成を指します。
それぞれのエージェントは、自分用の指示とツールを持ち、渡された範囲の作業だけを行います。
対になるのが単一エージェントで、1 つのエージェントが調べる・考える・書くを順番に全部こなします。
どちらもモデルの性能そのものは同じでよく、違うのは仕事の流し方です。
よく使われるのは指揮役と作業役に分ける形
いちばんよく見る形は、指揮役のエージェントが仕事を分解し、作業役のエージェントに配って、戻ってきた結果をまとめる構成です。
Anthropic はこれを orchestrator-workers と呼び、事前にサブタスクを決めきれない複雑な仕事に向くと説明しています。
Building effective agents(Anthropic)
OpenAI の Agents SDK のドキュメントでは、分け方を 2 つに整理しています。
- 指揮役が専門のエージェントを道具として呼び、会話の主導権は手放さない形(agents as tools)
- 専門のエージェントに会話そのものを引き渡し、その先は相手に任せる形(handoffs)
同じページでは、LLM に次の手を決めさせる流し方と、コードで順番や並列を決めておく流し方も比べられています。
コードで決めるほうが、速度やコストや結果を予測しやすいと書かれていました。
Agent orchestration(OpenAI Agents SDK)

単一エージェントとの違いはコンテキストの持ち方
分けることのいちばんの効き目は、各エージェントが自分のコンテキストウィンドウを持てる点にあります。
Claude Code のサブエージェントも、独立したコンテキストで作業して、要約だけを呼び出し元に返す仕組みです。
公式ドキュメントは、検索結果やログのように二度と見ない情報で会話を埋めたくないときに使うよう勧めています。
Subagents(Claude Code Docs)
単一エージェントだと、途中で読んだ大量の資料がすべて同じ会話に積み上がり、後半ほど判断が鈍りやすくなります。
マルチエージェントは、モデルを賢くする仕組みというより、1 つのコンテキストに入りきらない仕事を分けて運ぶ仕組みです。
Cursor の Subagents も同じ考え方で作られているので、具体的な使い方はこちらで紹介しています。
性能は上がるがトークンも増える
Anthropic は、自社のリサーチ機能をマルチエージェントで組んだときの社内評価を公開しています。
Claude Opus 4 を指揮役、Claude Sonnet 4 を作業役にした構成は、Claude Opus 4 単体より 90.2% 高い成績を出しました。
その一方で、エージェントはチャットのおよそ 4 倍、マルチエージェントはおよそ 15 倍のトークンを使うと書かれています。
性能が上がる代わりに、使うトークンも桁違いに増えると見ておくのが実態に近いでしょう。
同じ記事では、ブラウジングの評価で成績のばらつきの 80% をトークン使用量だけで説明できたとも述べています。
並列に読ませて使えるトークンを増やしたことが、性能が伸びた大きな理由だという分析です。
How we built our multi-agent research system(Anthropic)

同じモデルでも周辺の作り方でコストが変わる話は、エージェントハーネスの記事でも扱いました。
サブエージェントを並べた定期ルーティンで、増えた入力の中身を実行記録から数えた記録もあります。
向かない仕事もある
Anthropic の同じ記事は、全員が同じコンテキストを共有する必要がある仕事や、エージェント同士の依存が多い仕事には向かないと書いています。
コーディングは、調べ物に比べて本当に並列にできる作業が少ないとも指摘しています。
Devin を開発する Cognition は、もっとはっきり「マルチエージェントを作るな」という題の記事を出しました。
例に挙げられたのは、Flappy Bird の複製を作る仕事を分けた場面です。
背景を作る担当がマリオ風の背景を作り、鳥を作る担当がそれと合わない鳥を作ってしまい、最後にまとめる側が食い違いを直す羽目になります。
記事は、行動には暗黙の判断が含まれていて、判断が食い違うと悪い結果になると説明していました。
作業役どうしが互いの判断を見られないと、分けたぶんだけ食い違いの後始末が増えます。
Don't Build Multi-Agents(Cognition)
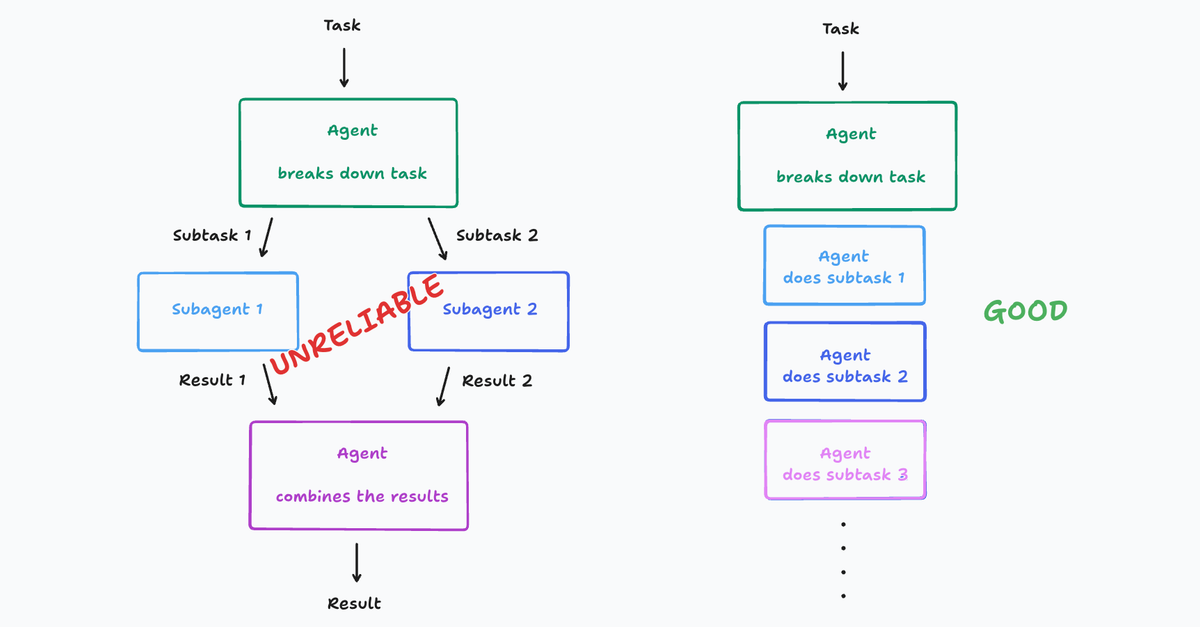
Anthropic も、指示があいまいだと作業役が同じ調査を重複したり抜けを作ったりすると書いており、両社が見ている問題は同じです。
分けるかどうかを決める目安
Anthropic は、複雑さは結果がはっきり良くなるときだけ足すべきだと勧めています。
まずは単一エージェントで試して、足りないと分かってから分けるのが順番として自然です。
分けるか迷ったときは、次の 4 つを確かめると判断しやすくなります。
- 互いの結果を待たずに進められる作業に切り分けられるか
- 各担当に渡す指示に、目的・範囲・返す形式を書き切れるか
- 担当が途中で下した判断が、他の担当の作業とぶつからないか
- トークンが何倍にも増えても見合う価値がある仕事か
調べ物を複数の観点から集める、大量のファイルを手分けして読むといった仕事は、この条件を満たしやすい部類です。
1 つの設計方針を保ったまま少しずつ作り込む仕事は、単一エージェントのまま進めたほうが崩れにくくなります。
Anthropic の記事も、簡単な事実確認ならエージェント 1 つでツール呼び出し 3〜10 回、複雑な調査なら 10 を超えるサブエージェントと、仕事の重さに応じて規模を変える指示を入れています。
最後に
マルチエージェントは、仕事を分けてそれぞれに専用のコンテキストを持たせる構成です。
並列に読ませる調べ物では成績が大きく伸びる一方で、トークンは 15 倍ほどに増え、判断の食い違いという新しい失敗も生まれます。
分けられる仕事かどうかを先に見て、分けられるときだけ分ける。
それだけ守れば、コストに見合う使い方から外れにくくなります。
以上です。

コメントを残す