学習に使えるデータが足りない、という話を最近よく見かけます。
集めるには費用がかかり、個人情報が絡めば使えるかどうかの確認から始まります。
そこで使われているのが、機械に作らせたデータ、いわゆる合成データです。
実在のログや文章の代わりに、モデルの学習用として人工的に生成したデータを指します。
AI の学習データがどこから来るのかを追っていくと、この言葉に必ず行き当たるのですね。
合成データはモデルに問題と答えを書かせたもの
いまの生成AIまわりで合成データと言えば、たいていは大きなモデルに生成させたテキストを指します。
たとえば、数学の問題とその解き方、コードとその説明、指示とそれに沿った応答があります。
こうした入力と出力の組を、既存のモデルに大量に書かせて学習用データにするわけです。
作り方はおおまかに3つあります。
- 大きなモデルに問題と解答を生成させる(蒸留に近い作り方)
- 既存データを言い換え・翻訳・条件変更して増やす(データ拡張)
- 規則やシミュレーションから機械的に組み立てる(ルールベース)
このうち一番伸びたのが1つ目で、性能の高いモデルの出力を、小さなモデルの教科書として使う流れができました。
大きなモデルの振る舞いを小さなモデルへ移す考え方そのものは、蒸留として整理しています。

足りないのは量ではなく「欲しい形のデータ」
合成データが要る理由は、単純な枚数不足だけではありません。
NVIDIA は合成データ生成向けのモデルを公開したとき、その動機を「高品質な学習データはモデルの性能を左右するのに、そろったデータセットは高価で入手が難しい」と説明していました。
NVIDIA「NVIDIA Releases Open Synthetic Data Generation Pipeline for Training Large Language Models」
実務で効いてくるのは、欲しい形に整ったデータが世の中に落ちていないという側面でしょう。
医療や金融のように、そもそも外へ出せないデータもあります。
事故や不正のような珍しいケースは、待っていても件数が集まりません。
社内フォーマットの帳票や、自社サービス特有の言い回しも、ウェブを探して見つかるものではありません。
合成データは、足りない量ではなく、足りない種類を埋める道具という位置づけになります。
公開データセットで実物を見てみる
話を具体化するなら、公開されている合成データセットを覗くのが早いです。
NVIDIA の Llama-Nemotron Post-Training Dataset は、モデルの事後学習に使われた合成データを丸ごと公開しています。
Llama-Nemotron-Post-Training-Dataset(Hugging Face)

中身の内訳は、数学が約2,206万件、コードが約1,010万件、科学が約70万件、そこに指示追従やチャット、安全性の小さな束が続く構成です。
応答を書いたのは DeepSeek-R1 や Qwen2.5 系、Llama 系といった既存のモデルたちです。
ライセンスは大部分が CC-BY-4.0 で、誰でも中身を確認できます。
どのモデルに何を書かせ、何件ずつ集めたのかまで見えるので、合成データという言葉の解像度がぐっと上がりました。
数学とコードに偏っているのも示唆的で、答え合わせがしやすい領域ほど合成しやすいという事情が透けて見えます。
落とし穴は「自分の出力を食べ続けること」
いいことばかりではありません。
合成データで最もよく引かれる警告が、モデル崩壊(model collapse)です。
Shumailov らは2024年の Nature 論文で、モデルが生成したデータを無差別に学習へ混ぜ続けると、元の分布の裾が消えて取り返しのつかない欠陥が残ると報告しました。
Nature「AI models collapse when trained on recursively generated data」
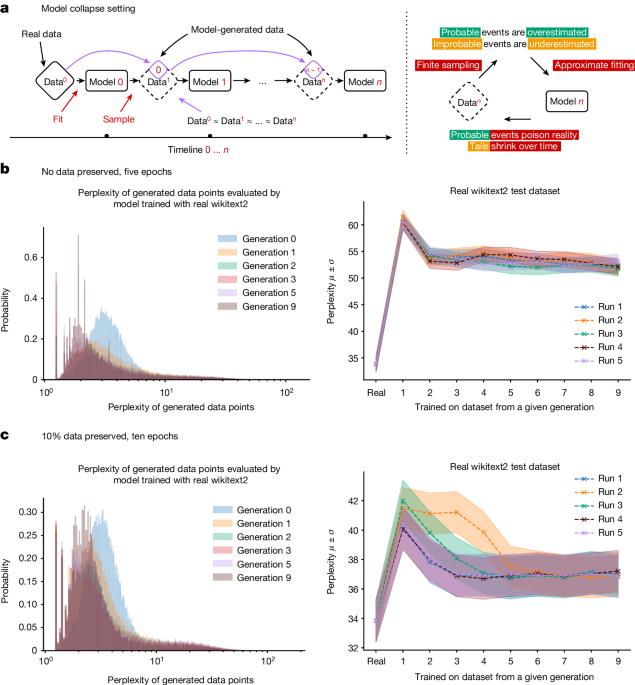
珍しい言い回しや少数派の事例から先に失われていく、という指摘なのですね。
もう一つ実務で怖いのが、評価データの汚染です。
学習データを作ったモデルと評価を書かせるモデルが同じなら、得意なことを得意な採点基準で測る閉じた輪ができあがります。
対策として語られているのは、生成しっぱなしにせず選別を挟むことです。
先ほどの NVIDIA のモデル群にも、応答を有用性・正確さ・一貫性・複雑さ・冗長さの5観点で採点する報酬モデルが含まれていました。
作る工程より、捨てる工程のほうが品質を決めるという構図です。
評価そのものをどう設計するかは、RAG の文脈で整理した記事も参考になると思います。
最後に
合成データは、モデルに書かせた学習データで、足りない種類を埋めるための道具でした。
公開データセットを見ると、数学やコードのように正解を確かめやすい領域から実用が進んでいます。
一方で、自分の出力を無選別に食べ続けると分布の裾が痩せていきます。
だからこそ生成より選別、そして評価用のデータは合成に頼りきらないという線引きが要ります。
私も自分でデータを用意する場面では、まず「これは合成で埋めていい種類か」を先に問うつもりです。
以上です。


コメントを残す